Agentes de IA para programar: cómo los creo con Claude Code
Un agente de IA es un programa que usa un modelo de lenguaje para perseguir un objetivo por su cuenta: decide qué pasos dar, usa herramientas y se detiene cuando el resultado está verificado. Los agentes de IA que uso para programar no son un chat: son seis archivos de texto con nombre, modelo y permisos, orquestados desde Claude Code. Aquí cuento qué son, qué tipos hay, y cómo crear agentes de IA que entreguen código ya revisado en repositorios y aplicaciones reales. El contexto general está en mi guía de Claude Code.
Qué es un agente de IA y qué lo diferencia de un chat
La diferencia no es el modelo. Es quién decide el siguiente paso.
Un asistente responde a un turno: preguntas en lenguaje natural y tú decides qué hacer con la respuesta. Un agente de IA recibe objetivos y herramientas, y hace su propia toma de decisiones sobre qué datos leer, qué comando correr en la terminal, qué API consultar y cuándo parar. Anthropic marca la línea en cómo construir agentes efectivos: los flujos de trabajo encadenan pasos fijos, mientras que los agentes de IA dirigen su propio proceso y su propio uso de herramientas. Los principios de diseño se repiten en cualquier dominio; lo que cambia en código son los datos que lee el agente de IA, las capacidades que le concedes y el criterio de éxito: que lo que entrega sobreviva a la revisión, no que la respuesta suene bien.
En la práctica, un agente de IA para programar tiene cuatro partes:
| Parte | Qué aporta | En mi configuración |
|---|---|---|
| Objetivo | qué resultado observable se busca | una plantilla con Outcome, Acceptance, Not in scope |
| Herramientas | qué acciones permite ejecutar | Read, Grep, Glob, Bash, edición de archivos |
| Contexto | qué información lee siempre | un archivo corto de reglas que apunta a documentos largos |
| Verificación | cómo sabe que terminó bien | un script del repositorio que bloquea el fin del turno |
Esa última fila separa a los agentes de IA útiles de una demo. Las buenas prácticas oficiales de Claude Code lo dicen sin rodeos: “Claude stops when the work looks done. Without a check it can run, ‘looks done’ is the only signal available, and you become the verification loop: every mistake waits for you to notice it.”
Dónde se queda corto: mi definición de “terminado” sigue siendo un script de checks, no criterios de aceptación ligados a pruebas, así que el agente de IA comprueba que nada se rompió, no que los resultados sean los que pedí. Es la brecha más honesta del sistema.
Tipos de agentes de IA para programar
La taxonomía clásica de la inteligencia artificial ordena los agentes inteligentes en reactivos, agentes basados en modelo, agentes basados en objetivos, de utilidad y agentes de aprendizaje, y describe los sistemas de IA de los libros de texto y casi nada de lo que uno construye hoy sobre un LLM: ninguno de mis agentes de IA hace aprendizaje en línea, el archivo es estático entre ejecuciones. Para trabajar conviene clasificarlos por rol y por modelo.
Por rol. Investigador (lee y entiende, nunca escribe), implementador (entrega un cambio pequeño y verificado), revisor (busca lo que el implementador no vio). Son agentes de IA especializados con fronteras duras: el investigador y el revisor no tienen herramientas de escritura, así que la separación no depende de que el modelo se porte bien. Cada uno declara sus capacidades en el encabezado y carga solo la información que su rol necesita.
Por modelo. Una escalera de costo, elegida por la complejidad de la subtarea y no por la del proyecto. Anthropic recomienda eso en su documentación de agentes personalizados: los modelos de IA se declaran por agente, no por sesión. Los modelos de lenguaje no son intercambiables entre tareas, y pagar el más caro para listar archivos es desperdicio.
Estos son los seis que sobrevivieron en mi configuración:
| Agente | Modelo | Herramientas | Para qué |
|---|---|---|---|
| investigador | opus | solo lectura | traza el flujo real, entrega un plan con file:line |
| implementador | opus | todas | un cambio por invocación, contra una rama de integración |
| revisor | opus | solo lectura | alcance, corrección, verificación, calidad, documentación |
| constructor | opus | todas | tareas ya especificadas, fuera del flujo formal |
| explorador | sonnet | todas | búsquedas de un propósito, ediciones pequeñas |
| mecánico | haiku | todas | inventarios, transformaciones, comandos fijos |
Los tres primeros son el flujo de trabajo de entrega. Los otros tres viven fuera de él: el constructor es el agente de trabajo por defecto para implementación ya especificada, el explorador toma trabajo acotado y el mecánico hace el reparto en paralelo, donde varios agentes de IA corren a la vez sobre datos distintos. La regla al dudar es tomar el escalón más barato.
Dónde se queda corto: no tengo datos que prueben que opus es necesario para el investigador. Es un juicio, no una medición de rendimiento.
Cómo crear agentes de IA en Claude Code
Construir agentes aquí es escribir un archivo Markdown con encabezado YAML. No hay que desplegar agentes en un servidor ni meter un framework de código abierto de por medio: el encabezado declara nombre, descripción, herramientas y modelo, y el cuerpo es el encargo permanente. Implementar agentes especializados cuesta minutos, y ahí está la trampa: lo fácil es la creación de agentes, lo difícil es decidir qué no pueden hacer.
Este es un revisor, con la misma estructura que uso en producción:
---
name: revisor
description: Revisa un diff. Corrección primero, calidad después.
tools: Read, Grep, Glob, Bash
model: opus
---

Revisas código escrito por otro agente. Tu valor está en encontrar lo
que el autor no vio: sé adversario, no complaciente. Nunca editas.

1. Alcance: ¿el objetivo declarado pide este cambio? Si no, es hallazgo.
2. Corrección: ¿qué entrada o estado hace que esto falle?
3. Verificación: ¿corrió los checks? Falta de prueba es hallazgo.

Cero hallazgos es un resultado legítimo. No inventes para lucir riguroso.
Tres decisiones cargan casi todo el peso.
La primera es tools. Omitir la línea permite el acceso completo; enumerarla convierte a los agentes de IA en fronteras de permisos. Un revisor sin herramientas de escritura no puede “arreglar” lo que critica, la falla que describe Anthropic en su diseño de harness: cuando se les pide evaluar su propio trabajo, los agentes de IA tienden a elogiarlo.
La segunda es la última línea del ejemplo. Las buenas prácticas advierten que un revisor al que le pides encontrar problemas reporta alguno aunque el trabajo esté bien, y que perseguir cada hallazgo lleva a sobre-ingeniería; autorizar el “no encontré nada” lo corrige.
La tercera es la brevedad. El archivo de reglas siempre cargado se mantiene corto y apunta a documentos que se leen bajo demanda: un contexto inflado hace que el modelo ignore las instrucciones que sí importan. La información que no se necesita en cada turno vive fuera.
Un orquestador que no escribe código
La topología es la de agentes efectivos: un modelo central descompone, delega y sintetiza. Mi sesión principal planea y decide, y no escribe una línea de código. El motivo es económico: el modelo caro se gasta en razonamiento y juicio, no en tecleo.
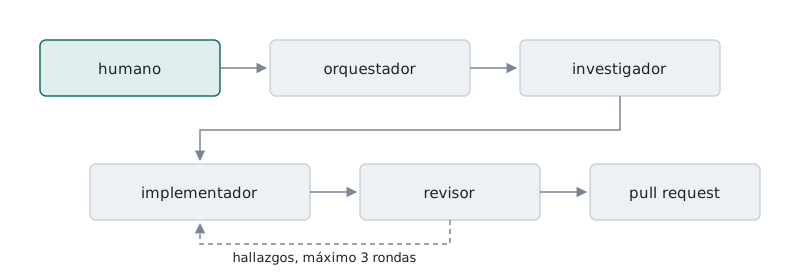
Las tareas se reparten por complejidad, no por volumen: los problemas complejos suben de escalón. Tres detalles hacen que estos sistemas de agentes funcionen con múltiples agentes y no con uno solo más grande:
- Los arreglos vuelven al mismo implementador. Ya tiene el plan, el diff y el razonamiento; recrearlo paga ese contexto dos veces. Cognition lo plantea como compartir trazas completas, no mensajes sueltos.
- Los agentes de IA se lanzan en segundo plano por defecto; el orquestador solo espera cuando el siguiente paso depende del resultado.
- Tres rondas y se escala al humano. Tres rondas fallidas significan que el plan está mal, no el código. Los comentarios de una persona no cuentan contra ese límite: la intervención humana siempre vale una ronda más.
Los hallazgos y las respuestas van firmados en su primera línea (🤖 reviewer · round N, 🔧 fix · <sha>). Suena cosmético, pero permite abrir un pull request y ver de un vistazo qué comentarios son míos y cuáles de los agentes de IA.
Dónde se queda corto: las escrituras siguen siendo de un solo hilo. Cognition, en su revisión de qué funciona en multiagente, concluye lo mismo: los sistemas multiagente rinden cuando los agentes extra aportan inteligencia, no acciones. Yo paralelizo los procesos de investigación y revisión; nunca dos implementadores sobre un mismo archivo.
Verificación obligatoria: hooks y revisión
La parte que más cambió mis resultados no es un agente de IA. Es un hook de Claude Code: un script que el sistema ejecuta en un evento, fuera del control del modelo.
El mío corre al final de cada turno. Si los checks del repositorio fallan, termina con código 2, y ese código bloquea el fin del turno: el agente no puede declarar victoria sin arreglar lo que rompió. La documentación oficial explica por qué es distinto de escribirlo en el archivo de reglas: “Unlike CLAUDE.md instructions which are advisory, hooks are deterministic and guarantee the action happens.”
Estos procesos corren fuera del modelo, y eso es todo el punto. Dos decisiones clave que me costaron aprender: el hook de verificación no hace nada si el repositorio no trae su propio script, porque adivinar la suite de pruebas de entornos desconocidos es peor que no correr nada; y el de formato nunca bloquea, porque un formateador roto no puede detener una edición.
La segunda capa es humana y mínima: el permiso para integrar un cambio es una señal explícita de una persona, y exige que la integración continua esté en verde. Los agentes de IA nunca integran solos: el cambio llega a los usuarios cuando una persona lo autoriza. El informe DORA 2025 documenta el riesgo de inestabilidad cuando la velocidad sube sin ese control. En sistemas de empresas con equipos grandes la supervisión humana se reparte; aquí soy yo, y por eso el punto de consentimiento es uno solo. Sobre por qué esta verificación separa esto del vibe coding, escribí en vibe coding vs. programación agéntica.
Ejemplos de agentes de IA en mi flujo
Tres casos de agentes de IA corriendo sobre datos y tareas del mundo real: repositorios y aplicaciones que uso a diario, no prototipos.
Entrega de una funcionalidad. El investigador entrega el plan con los datos del repositorio que lo sustentan. Yo decido la partición en subtareas de menos de 400 líneas cambiadas, ordenadas por dependencia; las que tocan código compartido van en serie. Cada una la toma un implementador en su propio worktree de git y abre un pull request contra una rama de integración, nunca contra la principal. Así la rama principal ve un solo cambio revisado y cada pieza recibe su revisión pequeña. Google lo argumenta en su guía de cambios pequeños; las 400 líneas son un techo, nunca una meta.
Caza de errores. Aquí la automatización agéntica trabaja sin que yo pida nada: un comando programado lee las fuentes de registro configuradas de mis aplicaciones, agrupa los errores que ya vieron los usuarios y manda cada hallazgo a un verificador que lo reproduce o lo descarta. Nada se convierte en issue sin un escenario de falla confirmado, con file:line. El tope es de cinco issues por ejecución y el resto va a un resumen único. Ese tope es la decisión clave: un rastreador lleno de hallazgos sin confirmar cuesta más tiempo del que ahorra.
Limpieza profunda de calidad. El ejemplo más claro de IA agéntica en paralelo: ocho especialistas simultáneos sobre el mismo diff, cada uno con una dimensión (reutilización, simplificación, eficiencia, altitud, responsabilidad única, adopción de biblioteca o plataforma, generalización, sobre-construcción). Cada uno de esos agentes de IA solo encuentra; el orquestador valida y aplica. La regla que los hace útiles es “mide antes de afirmar”: una mejora de rendimiento que se pudo medir y no se midió es una suposición sin datos, y se descarta. La novena dimensión es esa honestidad empírica, y vive en la aplicación, no en un agente de IA.
Esa pieza ataca algo medido: un estudio de agosto de 2026 sobre reparación automática de programas documenta que los parches de modelos son más verbosos que los humanos para el mismo arreglo. El paso de recorte corrige un sesgo conocido.
Lo que aprendí (y lo que no funcionó)
Un “director” encima del orquestador. Lo construí y lo revertí: un agente del mismo nivel que la sesión principal, por encima de ella, la duplica sin agregar capacidades. La jerarquía solo paga cuando el nivel de arriba tiene información que el de abajo no tiene.
Haiku dentro de los flujos formales. Probado y rechazado: la calidad no compensó el ahorro para investigar, implementar ni revisar cambios complejos. Son tareas complejas que el escalón barato no sostiene, y en esos casos el ahorro se paga en rondas de revisión. Haiku se quedó en el agente mecánico, fuera de los flujos, y ahí sí rinde.
Revisión cruzada entre modelos. El sesgo que motiva la intuición es real: Panickssery et al. (2024) ligan reconocer el propio texto con sobrevalorarlo. Pero la corrección más fuerte es la ejecución, no el proveedor: con ejecución de código el acuerdo del juez con la verdad sube de menos de 42% a cerca de 72% (Findeis et al. 2025, según la revisión de literatura). Mi revisor corre después de las pruebas, en contexto limpio y sin saber quién escribió el diff, la condición ciega de Chae et al. (2026). El resultado medido es asimétrico: Claude revisando Codex, +18.1 puntos; Codex revisando Claude, -8.6 (Xiang et al. 2026). El argumento completo está en mi guía de Claude Code.
Lo que sigue abierto: no mido nada. Sin datos de líneas entregadas, rondas de revisión ni retrabajo, una regresión sería invisible hasta que doliera. Anthropic es explícito sobre ese costo en su artículo sobre evaluaciones para agentes, y sugiere empezar con 20 a 50 tareas sacadas de fallas reales. Es mi siguiente paso.
Preguntas frecuentes
¿Qué hace un agente de IA?
Un agente de IA recibe un objetivo y lo persigue por su cuenta usando herramientas. En programación eso significa leer archivos y datos del repositorio, correr comandos, escribir funciones y verificar el resultado, decidiendo él mismo el orden de las acciones. Los agentes de IA no esperan instrucciones paso a paso: esa es la diferencia con el asistente de chat que usan los usuarios.
¿Cuáles son los tipos de agentes de IA?
La teoría clásica de los agentes de inteligencia artificial distingue agentes reactivos, agentes basados en modelo, agentes basados en objetivos, de utilidad y agentes de aprendizaje. Para programar conviene clasificarlos por rol (investigador, implementador, revisor) y por el modelo asignado, que determina el costo. En ambos casos la frontera real son las herramientas: los roles de solo lectura existen para no poder tocar lo que juzgan.
¿Cómo se hacen los agentes de IA?
Crear agentes de IA en Claude Code es escribir un archivo Markdown: nombre, descripción, lista de herramientas y modelo en el encabezado, y el encargo permanente en el cuerpo. No hace falta código ni infraestructura para desplegar agentes en entornos aparte: corren dentro de tu propia sesión. Lo difícil es decidir qué herramientas negarles y cómo se verifica automáticamente su trabajo.
¿Cuál es la diferencia entre IA y agente de IA?
La IA, incluida la IA generativa, es la capacidad de producir una respuesta a partir de unos datos de entrada. Los agentes de IA son esa capacidad envuelta en un bucle con objetivos, herramientas y un criterio de parada, capaz de tomar decisiones sobre sus propias acciones. Un modelo que redacta un correo es IA; un sistema que lee la bandeja del usuario, decide a qué responder, escribe y envía es un agente: esa toma de decisiones encadenada es lo que se llama IA agéntica. La diferencia con una automatización clásica es que los pasos no están fijados de antemano.
¿Cuánto cuesta crear un agente de IA?
El archivo es gratis; el costo es por token consumido, y el factor dominante es qué modelo asignas a cada uno. Los sistemas de IA con múltiples agentes consumen bastante más que un chat equivalente, así que la escalera de modelos es la palanca real: el caro solo para juicio y revisión adversaria, el intermedio para trabajo acotado, el barato para tareas mecánicas. Al dudar, baja un escalón: relanzar un agente que falló sale más barato que correr todos los procesos en el modelo grande.
Fuentes
- What are AI agents? Definition, examples, and types — Google Cloud, s.f.
- Building effective agents — Anthropic, 2024
- Best practices for Claude Code — Anthropic, 2025
- Types of AI Agents — IBM, 2025
- Create custom subagents — Anthropic, s.f.
- Harness design for long-running application development — Anthropic, 2026
- Don’t Build Multi-Agents — Cognition, 2025
- Multi-Agents: What’s Actually Working — Cognition, 2026
- Hooks reference — Anthropic, s.f.
- Announcing the 2025 DORA report — Google Cloud, 2025
- Small CLs — Google, s.f.
- Refine After Generation: Toward Correct and Concise Patches in LLM-based Program Repair — Luo et al., 2026
- Cross-Model LLM Code Review — Xiang et al., 2026
- Demystifying evals for AI agents — Anthropic, 2026
- How we built our multi-agent research system — Anthropic, 2025
- LLM Evaluators Recognize and Favor Their Own Generations — Panickssery, Bowman, Feng, 2024
- Can External Validation Tools Improve Annotation Quality for LLM-as-a-Judge? — Findeis et al., 2025
- LLM-as-a-Judge for Software Engineering: Literature Review, Vision, and the Road Ahead — He, Shi, Zhuo, Treude et al., 2025
- Self- and Other-Labels Induce Bidirectional Bias in LLM Judges — Chae et al., 2026